avalanche
Avalanche
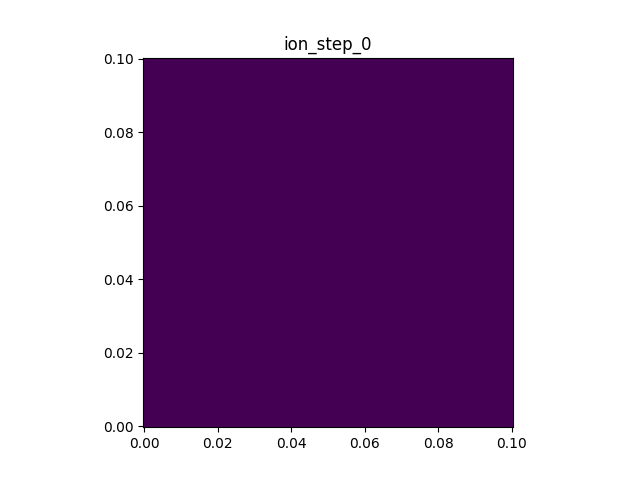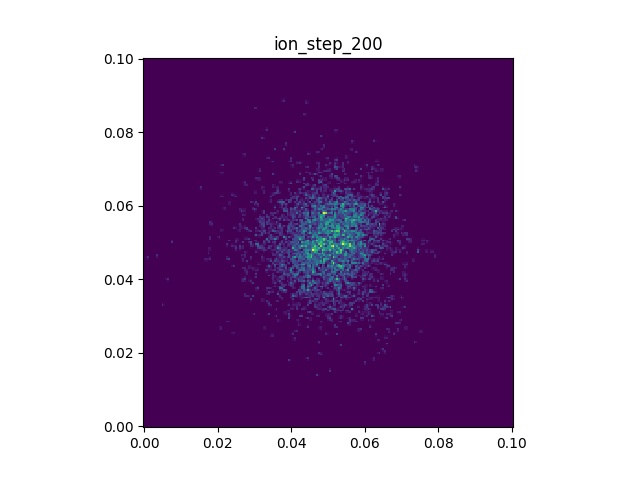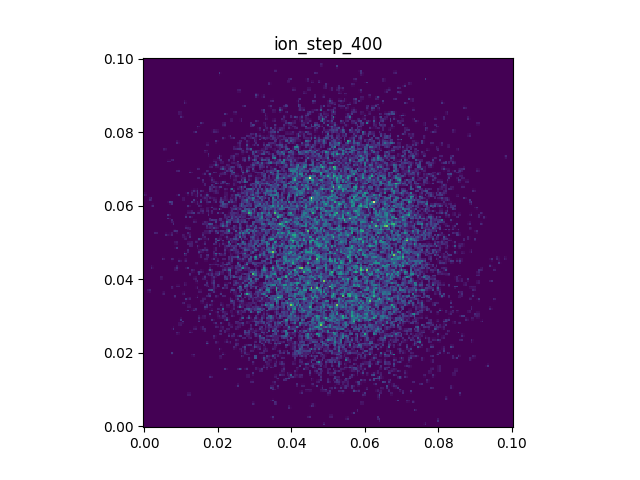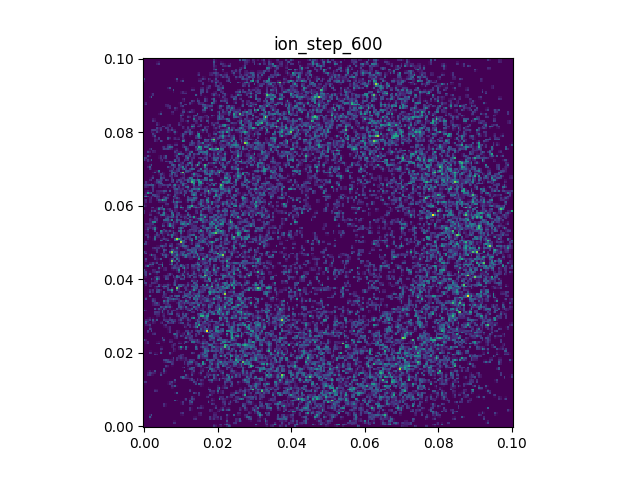
本教程演示 MCC 碰撞模块的用法。在二维区域中放置高速电子,背景为高斯分布的气团。 电子进入气团后发生碰撞:先是弹性散射改变飞行方向;加入电离碰撞后,次级电子继续碰撞电离,形成雪崩级联。
使用到的模块与特性:
particle_group粒子容器与for_each遍历node_field2D/host_node_field2D设备端与主机端场量add_back粒子→场沉积- MCC 碰撞模型(弹性散射 + 电离碰撞)
- 次级粒子产生与 buffer 机制
准备工作
在 example/avalanche/ 下新建 avalanche.cpp,然后按照每个 stage 逐步修改这个文件。
example/avalanche/stage_1.cpp 到 stage_5.cpp 是每个阶段结束时的参考答案,用来和自己的代码对照;不必当作必须运行的程序。
推荐从项目根目录进入算例目录,并加载编译环境:
这里的 output/ 里可能残留旧的 .plt、.png 或 .gif 文件。
可以先手动清空 output/。
首次运行速度:AdaptiveCpp 使用 JIT 机制在首次运行时编译内核导致耗时增加。本例粒子数较少,JIT 开销占比大,编译后的首次运行不反映真实性能。
Stage 1:粒子组与基本运动
在 avalanche.cpp 中,首先 include 必要的头文件并 using namespace:
#include <iostream>
#include <fstream>
#include <Eigen/Core>
#include <psum/psum.hpp>

using namespace std;
using namespace psum::prelude;
定义粒子类型。这里一个粒子有位置、速度和一个随机种子(本阶段暂不使用种子,留待 Stage 3 碰撞模块):
using Particle = tagged_struct<
    tag_bind<property::position, Eigen::RowVector2d>,
    tag_bind<property::velocity, Eigen::RowVector2d>,
    tag_bind<property::random_seed, uint32_t>
>;

using PG = particle_group<Particle, pos_x_nan_is_invalid>;
pos_x_nan_is_invalid 表示当粒子被标记为无效后,particle_group 的遍历会自动跳过它。
添加粒子推进函数,用欧拉法更新位置,并把离开网格的粒子标记为无效:
void move_particles(PG& pg, const auto& grid, double dt) {
    pg.for_each([&](sycl::handler& h) {
        return [=](Particle& p) {
            tag::get<property::position>(p) += tag::get<property::velocity>(p) * dt;
            if (!grid.inGrid(tag::get<property::position>(p)))
                PG::validator::make_invalid(p);
        };
    });
}
在 main 中创建队列、网格、粒子容器,并写一个运动循环,每个时间步注入一个电子、推进运动,并周期性记录粒子数到 count.plt:
int main() {
    sycl::queue q{sycl::default_selector_v};

    auto grid = simple_grid<2>({0.0, 0.0}, {0.1, 0.1}, {200, 200});

    PG electrons(q);

    ofstream count_file("output/count.plt");
    count_file << "variables=time,ele" << endl;

    double dt = 1e-10;
    int steps = 600, interval = 20;

    for (int step = 0; step <= steps; ++step) {
        move_particles(electrons, grid, dt);

        if (step % interval == 0) {
            count_file << step * dt << "\t" << electrons.size() << endl;
            cout << "step " << step << ": ele=" << electrons.size() << endl;
        }

        Particle p0;
        tag::get<property::position>(p0) = {0.001, 0.05};
        tag::get<property::velocity>(p0) = {6e6, 0.0};
        tag::get<property::random_seed>(p0) = global_random::rand_uint();
        electrons.insert({p0});
    }

    count_file.close();
    cout << "Avalanche stage 1: wrote count.plt." << endl;

    return 0;
}
编写 makefile 文件:
-include ../../config.mk

INCLUDES = -I ../../include -I ../../src

avalanche: avalanche.cpp
    $(ACPP) $(COMMON_FLAGS) $(INCLUDES) -o avalanche avalanche.cpp $(LIBS) $(LDFLAGS)
    mkdir -p output
    ./avalanche
(这些命令已经存在于 example/avalanche/makefile 中,只需要取消注释即可。)
后续每个阶段都这样编译和运行:
运行成功后,count.plt 中电子数会先线性增长,随后因边界吸收而趋于稳态。
这一阶段你只需要知道:
tagged_struct通过标签绑定属性名和类型,编译期确定内存布局。for_each使用双层 lambda 技巧操作每个粒子。- 离开网格的粒子通过
make_invalid标记为无效,后续for_each自动跳过。
这一阶段结束时的代码状态可以参考 example/avalanche/stage_1.cpp。
Stage 2:背景气团与主机端场量
从 Stage 1 的 avalanche.cpp 继续修改:
- 添加
host_node_field2D主机端场量和node_field2D设备端场量。 - 在主机端初始化高斯分布的氩气密度场。
- 拷贝到设备端并输出可视化。
在文件头部添加场量类型别名:
在 main 中,创建粒子容器之后、运动循环之前,添加主机端背景场量的初始化。
用高斯函数在主机端背景场上赋值,再用 copy 拷贝到设备端场量:
    PG electrons(q);

    Field atom_dens(q, grid);
    HField atom_host(grid);

    atom_host.setZero();
    Eigen::RowVector2d center{0.07, 0.05};
    double gas_r = 0.025;
    atom_host.for_each([&](size_t, double& v, const auto& pos) {
        v = 2e22 * exp(-((pos - center).squaredNorm() / gas_r / gas_r));
    });
    atom_host.plot("output/atom_dens.plt", "nAr", 0.0);
    atom_dens.copy(atom_host.getContent());
主机端 for_each 遍历每个节点,参数依次是节点索引、值引用、坐标引用。这里直接根据坐标计算高斯密度。
实际上对于设备端场量, 用
for_each也能做完全相同的事, 只是必须写双层 lambda, 略麻烦些。
makefile 中在运行程序后把 atom_dens.plt 转成图片:
avalanche: avalanche.cpp
    $(ACPP) $(COMMON_FLAGS) $(INCLUDES) -o avalanche avalanche.cpp $(LIBS) $(LDFLAGS)
    mkdir -p output
    ./avalanche
    python3 ../pltview.py output/atom_dens.plt
编译运行:
运行后应看到:output/atom_dens.png(静态背景气团),以及 count.plt(电子穿过气团但无碰撞,行为与 Stage 1 相同)。
这一阶段你只需要知道:
- 主机端场量用于初始化(逐节点根据坐标赋值),完成后拷贝到设备端供碰撞模块读取。
- 背景密度场是 MCC 碰撞概率计算的基础——密度越高,碰撞概率越大。
这一阶段结束时的代码状态可以参考 example/avalanche/stage_2.cpp。
Stage 3:MCC 弹性散射
从 Stage 2 的 avalanche.cpp 继续修改:
- 添加
Avalanche_mcc_model结构体,碰撞类型col_ionization的collide()暂时只实现散射改向部分(不产生新粒子)。 - 创建多物种粒子组(原子、离子)和对应密度场。
- 在循环中调用碰撞模型,观察电子在气团中的散射行为。
在 main 之前定义 MCC 模型。它声明了参与碰撞的物种(电子、氩原子、氩离子),并提供一个碰撞类型 col_ionization:
struct Avalanche_mcc_model {
    using e_tag = psum::particle_collision::species_tags::electron;
    using Ar_tag = psum::particle_collision::species_tags::Argon;
    using Ar1_tag = psum::particle_collision::species_tags::Argon_pos_1;
    using species_in_model = std::tuple<e_tag, Ar_tag, Ar1_tag>;

    struct col_ionization {
        static double collision_cross_section(double v2) {
            return v2 > 4e12 ? 2e-20 : 0;
        }
        static void collide(auto& p, const auto& ctx_acc) {
            using namespace psum::particle_collision::foundation;
            auto R = psum::random::view_as_rander(tag::get<property::random_seed>(p));
            double speed = tag::get<property::velocity>(p).norm();

            auto dir1 = psum::random::RandFunction2D::RandV_spherical(R.get_rander());
            tag::get<property::velocity>(p) = dir1 * speed * 0.9;
        }
    };
collision_cross_section(v2) 根据速度平方给出碰撞截面:速度平方大于阈值时有固定截面,否则为 0(低速不碰撞)。
collide() 本阶段只做散射改向:用随机种子取一个各向同性方向,乘以 0.9 倍原速(动能略有衰减)。
再给出一个 make() 工厂函数,把碰撞类型组装成可执行的 MCC 模型,并返回一个接收 dt 的 lambda:
    static auto make(PG& electrons, PG& atoms, PG& ions,
                     Field& ele_dens, Field& atom_dens, Field& ion_dens) {
        using namespace psum::particle_collision;
        using namespace psum::particle_collision::foundation;

        using processor_type = collision_processor<density_interp_2d<Ar_tag>, std::tuple<col_ionization>>;
        using all_col = mcc_model<mcc_submodel_for_incident<e_tag, processor_type>>;
        using Ctx = standard_mccm_context<species_in_model, PG, Field>;

        auto ctx = std::make_shared<Ctx>();
        ctx->template get<e_tag>().bind(electrons, ele_dens);
        ctx->template get<Ar_tag>().bind(atoms, atom_dens);
        ctx->template get<Ar1_tag>().bind(ions, ion_dens);

        return [ctx](double dt) {
            execute_mcc_model<all_col>(*ctx, dt);
            execute_all_clean_buffers<species_in_model>(*ctx);
        };
    }
};
组装链是编译期的:collision_processor(以氩原子密度插值为概率密度)→ mcc_submodel_for_incident(电子为入射粒子)→ mcc_model。运行时用 execute_mcc_model 执行一次碰撞步。
在 main 中创建原子、离子容器和对应的密度场(原子密度场与 Stage 2 的气团共用):
    PG electrons(q);
    PG atoms(q);
    PG ions(q);

    Field ele_dens(q, grid), atom_dens(q, grid), ion_dens(q, grid);
    HField atom_host(grid);
在气团初始化之后创建碰撞模型:
把 count.plt 的表头加上离子列:
在运动循环里,移动电子的同时也移动离子,并在移动之后、记录之前调用碰撞模型:
    for (int step = 0; step <= steps; ++step) {
        move_particles(electrons, grid, dt);
        move_particles(ions, grid, dt);

        mccm(dt);

        if (step % interval == 0) {
            count_file << step * dt << "\t" << electrons.size() << "\t" << ions.size() << endl;
            cout << "step " << step << ": ele=" << electrons.size() << ", ion=" << ions.size() << endl;
        }
makefile 不需要改动(输出仍是 atom_dens.plt 和 count.plt)。
编译运行:
运行后应看到:count.plt(ion 列始终为 0,电子因为不再直接飞离计算域,稳态数量上升),atom_dens.png,终端输出电子和离子计数。
这一阶段你只需要知道:
- MCC 类型组装链是编译期的,运行时通过
execute_mcc_model<Model>(ctx, dt)执行。 - 此时
collide()只改变入射粒子的飞行方向和能量,不产生新粒子(电离部分在 Stage 5 补完)。 - 速度衰减因子保证能量递减;低速时截面为零,碰撞自然停止。
这一阶段结束时的代码状态可以参考 example/avalanche/stage_3.cpp。
Stage 4:动能密度场与粒子沉积
从 Stage 3 的 avalanche.cpp 继续修改:
- 添加
node_field2D动能密度场ke_dens。 - 在循环中用
add_back将电子动能沉积到场量节点。 - 用
plot输出.plt文件并生成动画。
在密度场声明处加上动能密度场:
在记录分支里,先用 setZero 清零动能密度场,再用 add_back 把每个电子的动能(0.5 * v·v)沉积到周围节点,最后 plot 输出:
        if (step % interval == 0) {
            ke_dens.setZero();
            electrons.for_each([&](sycl::handler& h) {
                auto da = ke_dens.get_access(h);
                return [=](Particle& p) {
                    double ke = 0.5 * tag::get<property::velocity>(p).squaredNorm();
                    add_back(tag::get<property::position>(p), ke, da);
                };
            });
            ke_dens.plot("output/ke_step_" + to_string(step) + ".plt", "ke", step * dt);

            count_file << step * dt << "\t" << electrons.size() << "\t" << ions.size() << endl;
            cout << "step " << step << ": ele=" << electrons.size() << ", ion=" << ions.size() << endl;
        }
makefile 中在运行程序后把 ke_step_*.plt 合成动画:
编译运行:
运行后应看到:ke_step.gif(电子在气团中散射的动能密度动画),以及 count.plt、atom_dens.png。
这一阶段你只需要知道:
add_back根据粒子位置将值分配到周围 4 个节点。plot生成.plt文件,可用pltview.py查看单帧或合成动画。- 场量在每次 deposit 前需要
setZero。
这一阶段结束时的代码状态可以参考 example/avalanche/stage_4.cpp。
Stage 5:电离碰撞与雪崩级联
从 Stage 4 的 avalanche.cpp 继续修改:
- 在
col_ionization::collide()中补完电离部分:通过insert_particle_in_context产生次级电子和离子。 - 添加离子密度场的 deposit 和 plot。
- 将持续注入改为前 1/4 时间段注入。
在 collide() 里,散射改向之后,再产生一个次级电子和一个氩离子,通过 insert_particle_in_context 写入 buffer:
static void collide(auto& p, const auto& ctx_acc) {
using namespace psum::particle_collision::foundation;
auto R = psum::random::view_as_rander(tag::get<property::random_seed>(p));
double speed = tag::get<property::velocity>(p).norm();
auto dir1 = psum::random::RandFunction2D::RandV_spherical(R.get_rander());
tag::get<property::velocity>(p) = dir1 * speed * 0.9;
Particle new_ele;
tag::get<property::position>(new_ele) = tag::get<property::position>(p);
auto dir2 = psum::random::RandFunction2D::RandV_spherical(R.get_rander());
tag::get<property::velocity>(new_ele) = dir2 * speed * 0.8;
tag::get<property::random_seed>(new_ele) = R.get_rander().gen_seed();
insert_particle_in_context<e_tag>(ctx_acc, new_ele);
Particle new_ion;
tag::get<property::position>(new_ion) = tag::get<property::position>(p);
auto dir3 = psum::random::RandFunction2D::RandV_spherical(R.get_rander());
tag::get<property::velocity>(new_ion) = dir3 * 1e6;
tag::get<property::random_seed>(new_ion) = R.get_rander().gen_seed();
insert_particle_in_context<Ar1_tag>(ctx_acc, new_ion);
}
在记录分支里,仿照动能密度的写法,加上离子密度的 deposit 和 plot(注意离子按个数沉积,所以要除以单元面积):
ion_dens.setZero();
double area = grid.del<0>() * grid.del<1>();
ions.for_each([&](sycl::handler& h) {
auto da = ion_dens.get_access(h);
return [=](Particle& p) {
add_back(tag::get<property::position>(p), 1.0 / area, da);
};
});
ion_dens.plot("output/ion_step_" + to_string(step) + ".plt", "ni", step * dt);
最后把持续注入改为只在前 1/4 时间段注入(避免粒子数无限增长,让级联能自然终止):
if (step < steps / 4) {
Particle p0;
tag::get<property::position>(p0) = {0.001, 0.05};
tag::get<property::velocity>(p0) = {6e6, 0.0};
tag::get<property::random_seed>(p0) = global_random::rand_uint();
electrons.insert({p0});
}
makefile 中再加上 ion_step 和 count 的绘图(count.plt 是多列曲线,pltview.py 会自动画出多条并加图例):
    ./avalanche
    python3 ../pltview.py output/atom_dens.plt
    python3 ../pltview.py ke_step output
python3 ../pltview.py ion_step output
python3 ../pltview.py count output
编译运行:
运行后应看到:ion_step.gif(离子密度动画),count.png(电子和离子数指数增长曲线),ke_step.gif(级联扩散),atom_dens.png。
这一阶段你只需要知道:
- 次级粒子不能直接插入
particle_group,必须先写入 buffer,由框架统一插入。 - 每次电离产出 3 个粒子:入射电子(减速改向)+ 次级电子 + 氩离子。尽管参数与物理真实的碰撞处理不同,但代码写法一致。
这一阶段结束时的代码状态可以参考 example/avalanche/stage_5.cpp。
输出和常见错误
pltview.py 有两种常用方式:
第一种用于单个 .plt 文件,通常生成对应的 .png。
第二种用于一组文件,会在 output/ 中查找匹配的 .plt 文件并合成动画。
count.plt 包含多列数据,pltview.py 会自动绘制多条曲线并添加图例。
常见错误可以先这样排查:
make: acpp: No such file or directory:通常是没有执行source ../../env_load.sh。No rule to make target 'avalanche':当前目录不对,或者 makefile 中还没有取消注释avalanche目标。No rule to make target 'avalanche.cpp':已经有avalanche目标,但还没有在当前目录新建avalanche.cpp。- 没有生成
output/...文件:确认 makefile 里有mkdir -p output,并且程序是在example/avalanche/下运行。 pltview.py没有打印wrote ...:说明绘图脚本没有成功跑完,往上看终端中的 Python 报错。- 粒子数为 0 或不增长:检查背景密度场是否正确设置(
atom_dens.plt),以及碰撞截面和速度阈值是否匹配。 - 看到
AdaptiveCpp Warning:通常是运行时 JIT 编译提示,不一定是程序错误;只要程序继续输出并生成文件即可。